Agenții AI îți citesc site-ul. Fișierele făcute special pentru ei, aproape deloc
de Cătălin Popa · actualizat 2026-10-06
Toată lumea vorbește acum despre fișiere pentru AI: llms.txt, variante Markdown, drafturi noi depuse la IETF. Între timp, primul experiment mare despre ce citesc efectiv agenții a apărut pe 28 septembrie, iar concluzia lui e mai puțin spectaculoasă și mai utilă: contează pagina ta obișnuită, nu fișierul nou. Am citit studiul până la tabele, am pus alături măsurătorile din loguri și am verificat 30 de site-uri de firme mici din România.
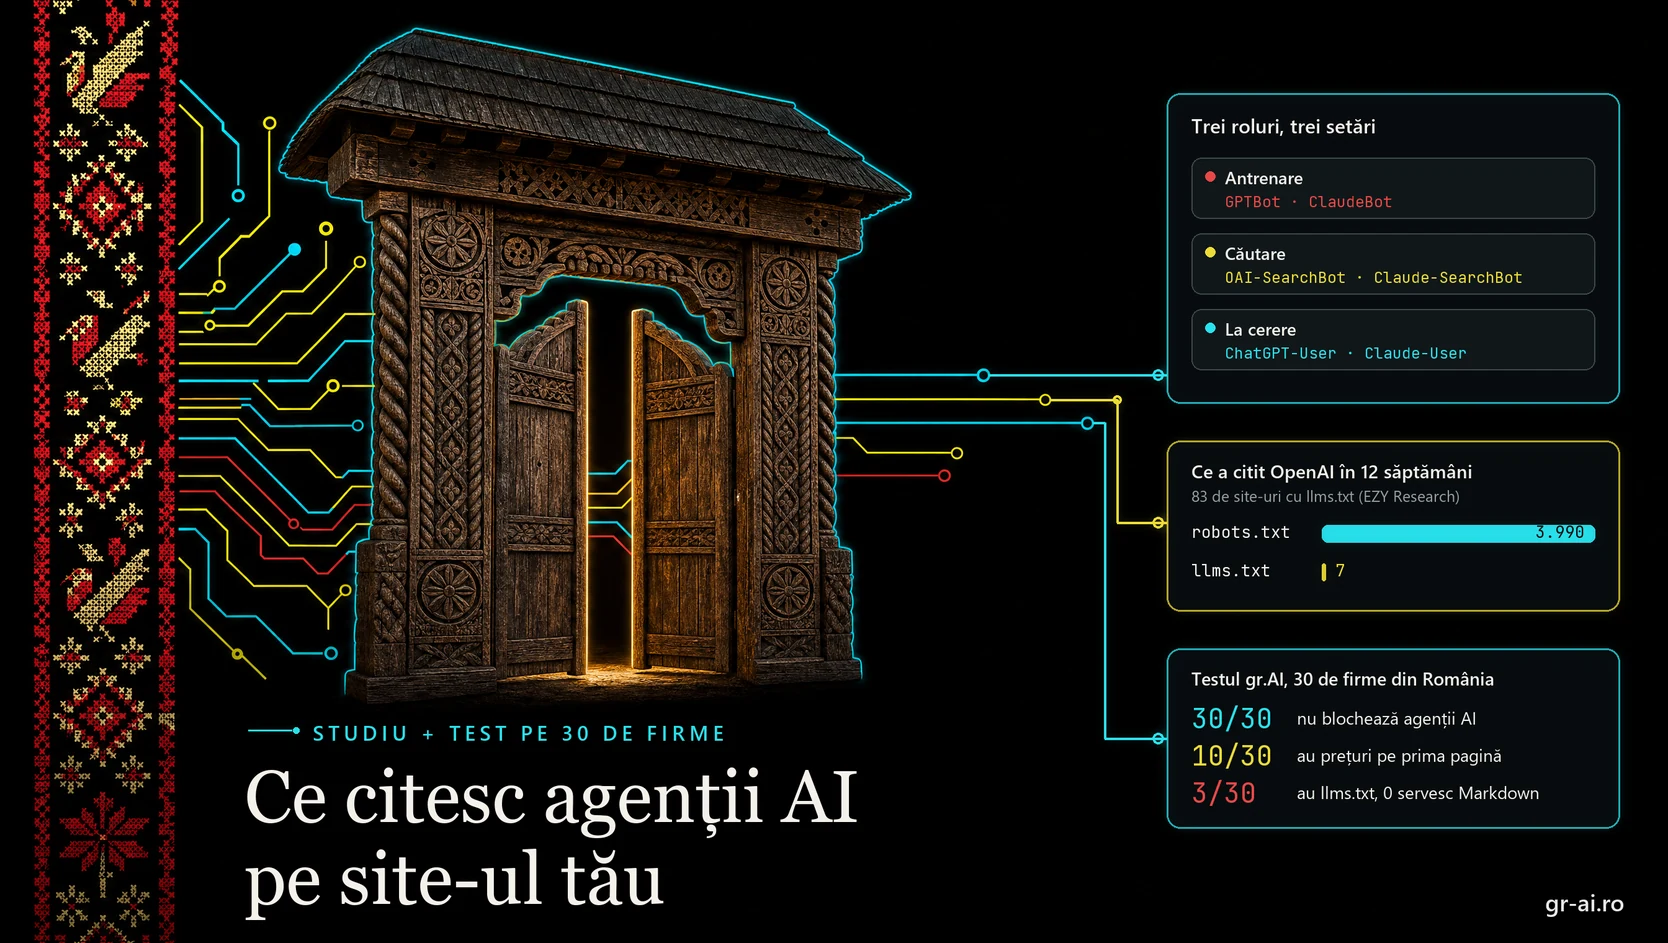
Ce citesc agenții AI când cineva întreabă despre firma ta?
Agenții AI care răspund la întrebări despre o firmă citesc paginile ei obișnuite chiar în momentul întrebării și construiesc răspunsul din ce găsesc acolo. Într-un experiment pe 1.056 de firme, cele cu site-uri ușor de citit de agenți au fost recomandate clar de aproape două ori mai des, iar când agentul n-a putut citi site-ul a răspuns oricum, din alte surse, și a omis mai des exact faptele cerute. Fișierele create special pentru AI, ca llms.txt, sunt însă rar cerute de crawlerele marilor platforme, iar Google spune că Search nu are nevoie de ele. Prioritatea rămâne un site care lasă agenții să intre și pune informația esențială direct în pagină. Am verificat 30 de firme din România: niciuna nu blochează agenții AI în robots.txt și aproape toate au text în pagină, dar doar 10 au prețuri pe prima pagină, 3 au llms.txt și niciuna nu servește Markdown.
Cine îți vizitează, de fapt, site-ul
OpenAI și Anthropic își împart boții pe trei roluri, iar diferența contează mai mult decât orice fișier nou. Unul adună text pentru antrenarea modelelor. Altul indexează pentru căutarea din asistent. Al treilea citește o pagină chiar în clipa în care un om pune o întrebare. Studiul de mai jos măsoară tocmai al treilea rol.
- Antrenare
GPTBot · ClaudeBotBlocarea scoate conținutul tău viitor din datele de antrenare.
- Indexare pentru căutare
OAI-SearchBot · Claude-SearchBotBlocarea te scoate din rezultatele de căutare ale asistentului.
- Citire la cererea utilizatorului
ChatGPT-User · Claude-UserOpenAI spune că, fiind acțiuni pornite de om, robots.txt s-ar putea să nu se aplice. Anthropic spune că și Claude-User îl respectă.
Setările sunt independente: poți refuza antrenarea și lăsa căutarea și citirea la cerere. Dar o regulă generală de tip „blochează boții AI”, din robots.txt, din firewall sau din CDN, le taie pe toate trei deodată, adesea fără ca cineva să fi decis asta conștient.
Ce a arătat cel mai mare experiment de până acum
Patru cercetători de la ora research au publicat pe arXiv, pe 28 septembrie, un experiment pe 1.056 de firme: 37.927 de sesiuni, cu patru combinații de agent și model (Claude Agent SDK cu Sonnet 4.6, Claude Code cu Haiku 4.5 și două variante GPT-5.4 cu căutare Tavily). Fiecare agent a primit aceleași trei tipuri de întrebări despre o firmă anume: prețuri, funcționalități, cum începi. Firmele au fost împărțite în două grupuri, după cât de ușor le citește un agent site-ul, și împerecheate pe faimă și pe prezența în datele de antrenare.
Site-urile ușor de citit, față de celelalte:
- din textul răspunsului vine din paginile firmei78% față de 58%
- dintre răspunsuri recomandă clar firma, de 1,9 ori mai des20% față de 11%
- dintre răspunsuri spun că agentul n-a putut accesa site-ul3,6% față de 15,9%
- dintre sesiuni s-au lovit de erori sau de ziduri anti-bot15,8% față de 33,5%
- din textul răspunsului vine din memoria modelului7% față de 10%
Trei limite, spuse direct. Întrebările numeau mereu firma, deci studiul nu spune nimic despre întrebările deschise de tip „cel mai bun X din orașul Y”, unde se decide dacă ești găsit. Scorul care separă grupurile aparține firmei autorilor și e compus: conținut fără JavaScript, date structurate, llms.txt, Markdown, reguli anti-bot, toate la un loc, fără efectul fiecăruia separat. Iar eșantionul e în engleză, dominat de SaaS și comerț. Cel mai clar semnal din lucrare e și cel mai banal: site-urile nepregătite blocau agentul de două ori mai des.
Pasul de găsire îl atinge un alt studiu, publicat pe 19 septembrie de Benjamin Tannenbaum, pe aproape 35.000 de răspunsuri GPT și Gemini la întrebări fără numele mărcii. Când motorul a citat domeniul propriu al firmei, marca a fost menționată în 49% din răspunsuri la GPT și în 58% la Gemini, față de 3 până la 4% când nu l-a citat. E o asociere, nu o cauză, iar autorul vinde unelte de măsurare. Dar se potrivește cu restul: site-ul tău contează și când nu te caută nimeni pe nume.
Eșecul tipic e tăcerea, nu minciuna
Când agentul nu poate citi site-ul, nu se oprește. Răspunde oricum, din căutări și din site-uri străine. Iar diferența nu stă în ce inventează: faptele spuse greșit cresc doar de la 4% la 6%. Stă în ce lipsește: faptele cerute și nemenționate cresc de la 29% la 45%.
Cel mai mare câștig, când răspunsul vine din site, e la prețuri: 60% din faptele cerute corecte, față de 37% când răspunsul vine din web. La întrebările despre configurare câștigul e nul, pentru că informația stă în documentație greu de găsit. Comparația e făcută pe aceeași firmă, cu același agent și același tip de întrebare.
Un site pe care agentul nu-l poate citi nu te scoate din răspuns. Te lasă în el, descris de alții, cu bucăți lipsă.
Fișierele făcute pentru AI: cine le citește
Aici datele merg în sens invers. Patru măsurători independente, din loguri reale:
- Draftul Arsentev, 5 octombrie.
Un editor și-a pus fișierul pe site și a numărat: în cele 3 zile cu fișierul instalat, crawlerele au citit robots.txt de 698 de ori și fișierul de context niciodată. Autorul spune singur limitele: un singur editor, identitatea boților neverificată.
- EZY Research, iulie.
Pe 83 de site-uri, în 12 săptămâni, OpenAI a citit robots.txt de 3.990 de ori și llms.txt de 7 ori. Anthropic: 3.120 față de 9. PerplexityBot: 775 față de 0.
- Ahrefs, iunie.
Pe 137.210 domenii analizate, 97% dintre fișierele llms.txt existente n-au primit nicio cerere în toată luna mai.
- Evil Martians, iulie.
Pe un singur site, în două luni, ChatGPT-User a cerut HTML în 99,9% din cazuri. Doar agentul de programare Claude Code a cerut Markdown, în 76% din cererile lui, prin antetul Accept, nu prin llms.txt.
Și Google scrie, în ghidul pentru funcțiile AI din Search, actualizat pe 10 iulie, că nu ai nevoie de fișiere noi pentru mașini, de fișiere text pentru AI sau de Markdown ca să apari acolo, și că astfel de fișiere nici nu ajută, nici nu strică. Trei dintre cele patru măsurători vin de la firme care vând unelte sau servicii pe acest subiect, deci merită citite cu atenție. Dar toate arată în aceeași direcție.
Agenții citesc, în cea mai mare parte, HTML-ul paginilor tale. Fișierul nou rămâne, deocamdată, un accesoriu.
Standardele, încă în fierbere
Problema e cum află un agent că fișierul există, și are trei răspunsuri, niciunul standard. llms.txt v2, din 10 august, leagă paginile de fișier cu relații de link obișnuite: describedby spre llms.txt și alternate spre varianta Markdown. Un draft depus la IETF de Evgenii Arsentev, revizuit pe 5 octombrie, vrea o adresă fixă, /.well-known/llm-context, o relație nouă și o linie nouă în robots.txt. Un al doilea, al lui Andrei Nicolae Besleaga, din 30 septembrie, propune un singur document JSON cu toate fișierele de cunoaștere ale site-ului, fiecare putând avea amprenta lui SHA-256.
Ambele sunt drafturi individuale: oricine poate depune unul, iar IETF scrie explicit că n-au niciun statut în procesul de standardizare. Merită urmărite, nu implementate în grabă. Un lucru bun au amândouă: cer ca agentul să trateze conținutul fișierului ca date, niciodată ca instrucțiuni.
WordPress: Markdown pentru agenți și o ușă nouă pentru acțiuni
Pluginul oficial AI pentru WordPress, versiunea 1.4.0 din 5 octombrie, cu peste 50.000 de instalări, are un experiment numit Markdown Feeds, care servește articolele și paginile în Markdown. E oprit implicit. Variantele Markdown primesc noindex, dar nu și canonical, iar negocierea prin antetul Accept e o a doua bifă, oprită și ea, cu un avertisment despre cache. Pluginul nu are încă traducere în română.
Adaptorul MCP 0.7.0, intrat pe 2 octombrie în directorul oficial, e altceva: nu ține de vizibilitate, ci de acțiuni. Îi permite unui agent să execute funcții pe site. Serverul implicit pornește singur la activare și, implicit, poate intra orice utilizator autentificat cu dreptul de citire, adică și un simplu abonat. Pe un magazin unde orice client are cont, trebuie verificat ce funcții sunt expuse. Pentru firmele cu obligații NIS2, ăsta e un punct de inventar, nu de marketing.
Testul nostru: 30 de firme din România
Am luat din OpenStreetMap, aceeași hartă deschisă ca la testul cu hoteluri, magazinele, birourile și atelierele cu site declarat din șase orașe: București, Cluj-Napoca, Iași, Timișoara, Brașov și Constanța. Am scos lanțurile etichetate pe hartă și dublurile, și au rămas 1.488 de adrese cu site. Am amestecat lista la întâmplare și am luat câte cinci site-uri proprii care funcționează din fiecare oraș. Pe fiecare am citit pagina principală fără JavaScript și robots.txt, am căutat llms.txt și am cerut pagina în Markdown, prin antetul Accept, pe 6 octombrie 2026.
Ca să ajung la 30 am tras 46 de puncte de pe hartă. La 8, site-ul nu a răspuns nici la a doua încercare. Alte 7 erau instituții publice, o ambasadă, o organizație politică sau un mall, pe care le-am scos, pentru că testul e despre firme. La unul, numele firmei nu apărea pe site. Cele 30 rămase sunt mai ales firme mici, de la o librărie și o cofetărie până la un atelier de reparat pantofi și un birou de traduceri, dar și câteva mari, cum e DIGI.
Ce am găsit pe cele 30 de site-uri:
- nu blochează niciun agent AI în robots.txt30 din 30
- au text în pagină fără JavaScript29 din 30
- își pomenesc orașul pe prima pagină26 din 30
- au telefonul pe prima pagină17 din 30
- au prețuri pe prima pagină10 din 30
- au date structurate despre firmă3 din 30
- au llms.txt3 din 30
- servesc Markdown la cerere0 din 30
Imaginea e aproape opusă discuției din industrie. Ușa e deschisă: niciun robots.txt nu blochează agenții AI, iar 29 din 30 de pagini au text fără JavaScript. Fișierele noi sunt rare: 3 din 30 au llms.txt, unul generat automat de Yoast, și niciuna nu servește Markdown. Ce lipsește e exact ce caută un agent: doar 10 din 30 au prețuri pe prima pagină, 17 au telefonul acolo, iar date structurate despre firmă au doar 3. Prețurile pot sta pe alte pagini, dar un agent care pornește de pe prima pagină trebuie să ajungă la ele, iar prețurile sunt tocmai faptele la care studiul ora a găsit cel mai mare câștig când răspunsul vine din site.
Limitele, spuse direct: un eșantion mic, ales dintre firmele care au site pe harta deschisă OpenStreetMap; doar pagina principală, verificată o singură dată, fără JavaScript. Robots.txt nu prinde blocările din firewall sau din CDN, pe care nu le-am testat, pentru că nu ne dăm drept boții altcuiva. Publicăm metoda și cifrele agregate, nu lista firmelor.
Ce faci, în ordinea dovezilor
Ordinea e după cât de puternică e dovada, nu după cât de nou e subiectul.
- Lasă să intre agenții la cerere și pe cei de căutare.
Verifică robots.txt, dar și pluginurile de securitate, firewall-ul hostingului și CDN-ul. Decide separat: antrenare (GPTBot, ClaudeBot), căutare (OAI-SearchBot, Claude-SearchBot), citire la cerere (ChatGPT-User, Claude-User).
- Pune răspunsul în HTML-ul inițial.
Prețuri, pachete, program, zonă deservită, condiții: totul trebuie să existe în pagina descărcată fără JavaScript. Testul simplu: descarci pagina fără browser și cauți cifra.
- Publică faptele pe care le cere cumpărătorul.
Eșecul tipic e omisiunea. Dacă prețul nu e pe site, agentul îl ia de altundeva sau nu îl spune deloc.
- Păstrează datele structurate, fără așteptări magice.
Google spune că nu există un marcaj special pentru AI, dar recomandă datele structurate în continuare, pentru SEO. Valoarea lor e coerența: aceleași date peste tot.
- llms.txt: opțional, mic și curat.
E ieftin, iar pe WordPress îl pot genera Yoast SEO sau AIOSEO. Leagă-l din pagini, ține-l scurt, fără nimic care să sune a instrucțiune, și nu promite nimănui trafic din el.
- Markdown: doar dacă ai un motiv.
Beneficiul documentat e la agenții de programare. Înainte să-l pornești, verifică dacă cache-ul și CDN-ul respectă antetul Vary: Accept.
- MCP doar cu un caz de utilizare clar.
Și cu lista funcțiilor expuse verificată după fiecare plugin nou instalat.
- Măsoară în propriile loguri, pe agent.
Google Analytics nu vede vizitatorii fără JavaScript. Verifică și adresele IP pe listele publicate de OpenAI și Anthropic, pentru că User-Agent-ul se poate imita: la Arsentev, cam o treime din cererile „de crawler” au ocolit CDN-ul și niciuna nu venea de la adresele publicate de operatori.
Întrebări frecvente
- Am nevoie de llms.txt ca să apar în ChatGPT?
- Nu există dovezi că ar ajuta. Măsurătorile publicate arată că crawlerele marilor platforme îl cer foarte rar, iar Google spune că Search nu are nevoie de el. Îl poți avea pentru că e ieftin, dar nu e prioritatea.
- Agenții AI văd conținutul încărcat cu JavaScript?
- De regulă, nu. Majoritatea descarcă pagina fără să ruleze JavaScript, deci prețurile sau descrierile încărcate ulterior pot lipsi complet din ce citesc. Informația esențială trebuie să fie în HTML-ul inițial.
- Dacă blochez GPTBot, dispar din ChatGPT?
- Nu neapărat. La OpenAI, GPTBot ține de antrenare, OAI-SearchBot de apariția în căutarea ChatGPT, iar ChatGPT-User de vizitele făcute la cererea unui utilizator. Setările sunt independente și se decid separat.
- Ce e varianta Markdown a unei pagini și îmi trebuie?
- E o copie text curată a paginii, pentru programe. Agenții de programare o cer deja, dar pentru un site de prezentare beneficiul nu e demonstrat, iar fiecare variantă e o adresă în plus de gestionat.
- E periculos să instalez MCP pe WordPress?
- MCP le permite agenților să execute acțiuni pe site, nu doar să-l citească. Implicit cere un utilizator autentificat, dar pragul e jos, așa că verifică ce funcții sunt publice și oprește serverul implicit dacă nu îl folosești.
De unde vin datele
- Studiul ora research. Finder, Elovic, Shalev și Yosef, „AX is the New AEO”, arXiv 2609.34951, 28 și 29 septembrie 2026, citit integral, cu tabelele.
- Studiul Tannenbaum. „From Prompt to Recommendation”, arXiv 2609.23162, 19 septembrie 2026.
- Drafturile depuse la IETF. draft-arsentev-llm-context-discovery, reviziile din 11 septembrie și 5 octombrie 2026, și draft-besleaga-agentic-knowledge-wellknown, 30 septembrie 2026, ambele drafturi individuale, fără statut în IETF.
- llms.txt v2. llmstxt.org și pagina de modificări, versiunea din 10 august 2026.
- Măsurătorile din loguri. Ahrefs (15 iunie 2026, pe 137.210 domenii), EZY Research (27 iulie 2026, pe 83 de site-uri) și Evil Martians (21 iulie 2026, pe un site, două luni).
- Google Search Central. Ghidul de optimizare pentru funcțiile AI generative din Search, actualizat pe 10 iulie 2026.
- Documentația OpenAI și Anthropic despre boți. Paginile despre GPTBot, OAI-SearchBot și ChatGPT-User, respectiv ClaudeBot, Claude-SearchBot și Claude-User.
- WordPress. Pluginul oficial AI 1.4.0 (5 octombrie 2026), cu codul experimentului Markdown Feeds citit la versiunea publicată, și MCP Adapter 0.7.0 (2 octombrie 2026), cu documentația serverului implicit.
- Testul nostru. 30 de firme din șase orașe, trase la întâmplare din OpenStreetMap și verificate pe 6 octombrie 2026, doar prin citire, fără JavaScript, cu un User-Agent care spune cine suntem.
Trimite articolul mai departe
Mai departe
- Cum verific dacă site-ul meu poate fi citit de un AITestul din articol, făcut singur, în zece minute
- Ce înseamnă noul feed de hoteluri din ChatGPT pentru un hotel din RomâniaAcelași tip de test, pe 30 de hoteluri și pensiuni
- La ce folosesc datele structurate pentru AICe rămâne valabil când fișierele noi nu ajută
- Dacă vrei verificarea făcută pe site-ul tăuAccesul, pe fiecare rol de bot, și ce găsește un agent în pagină